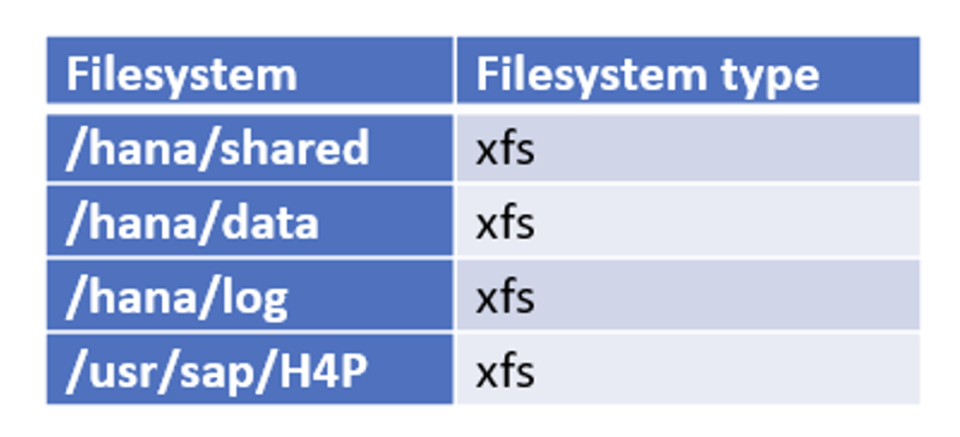
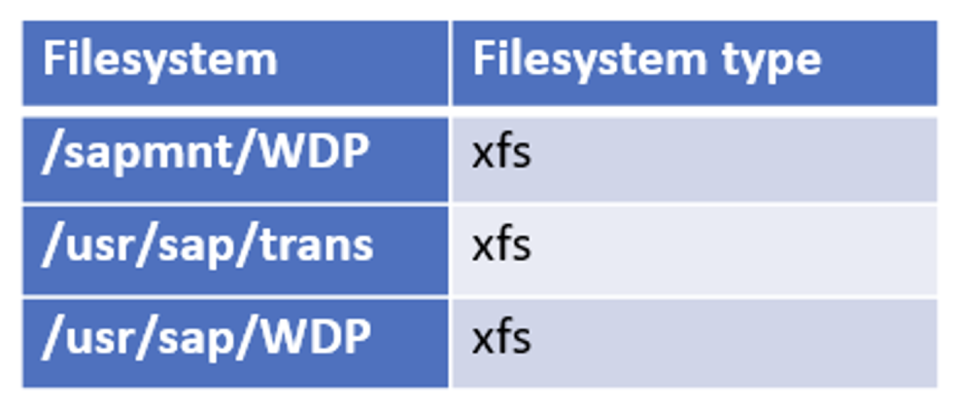
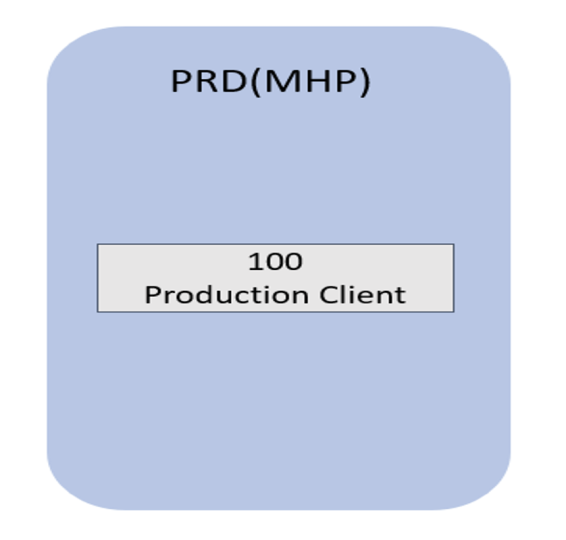
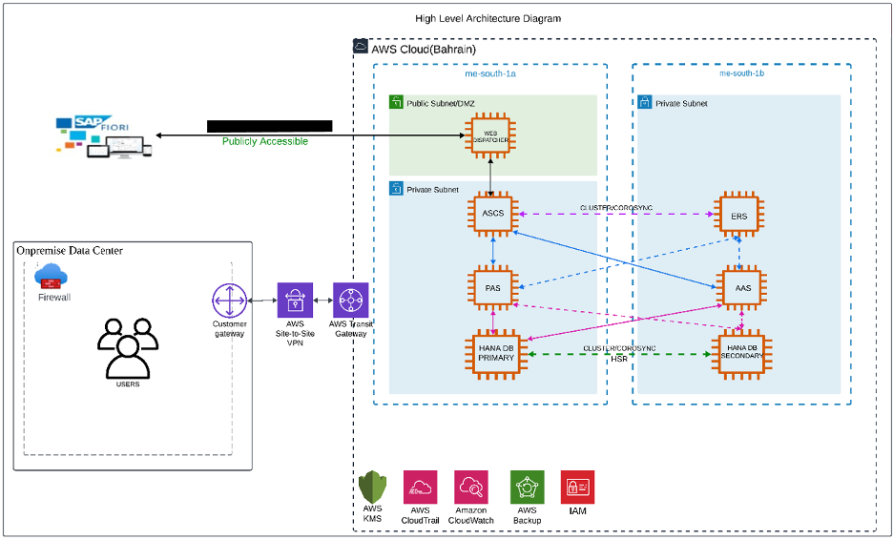
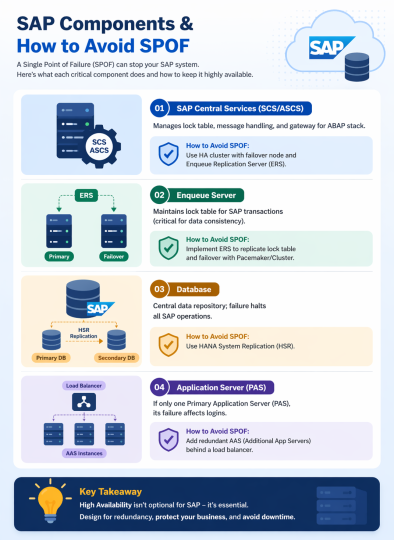
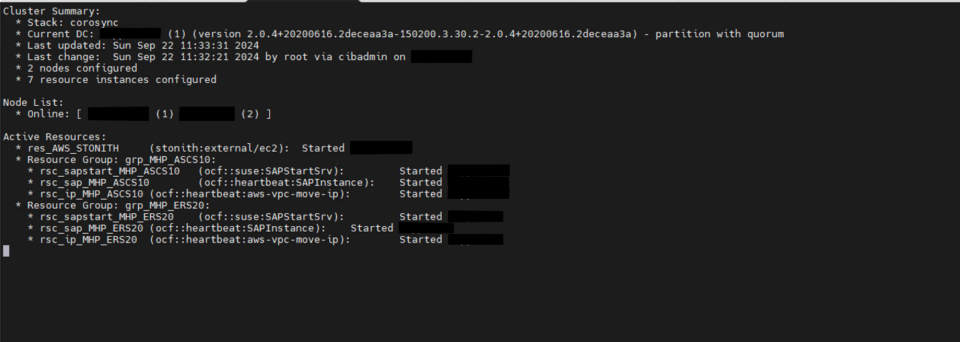
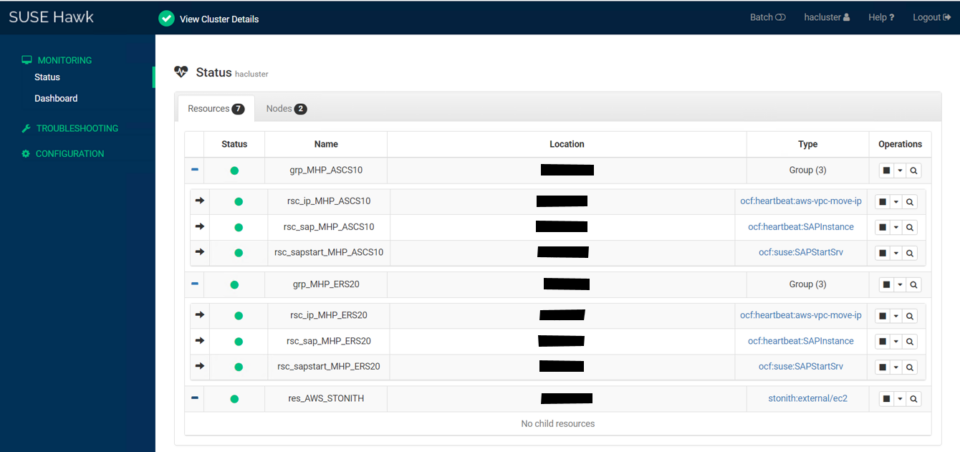
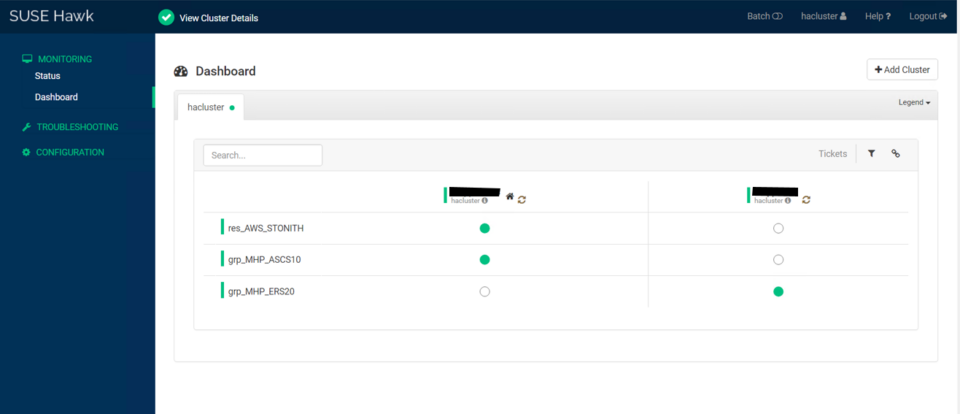
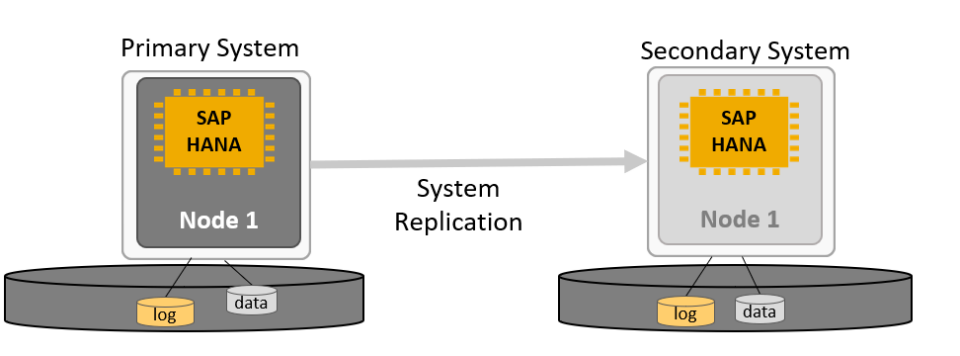
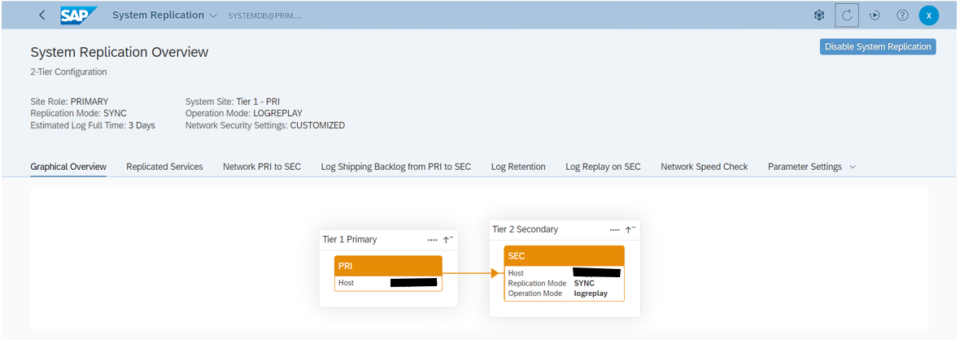
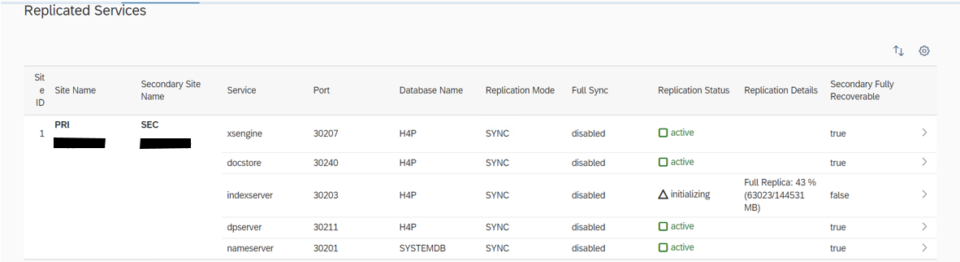
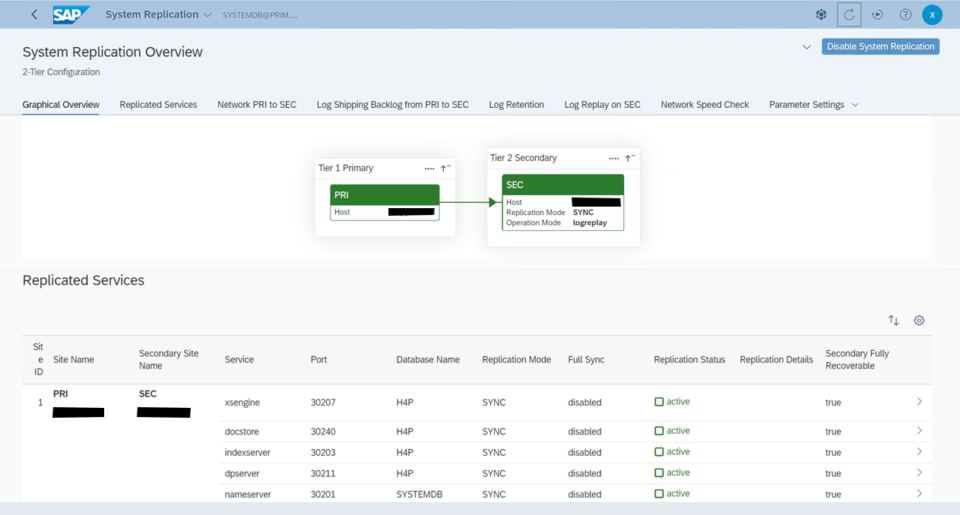
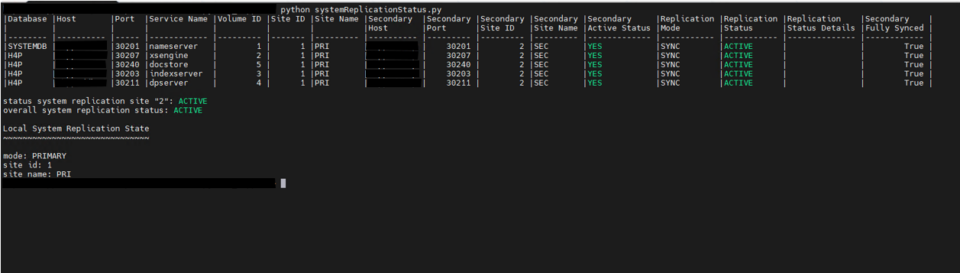
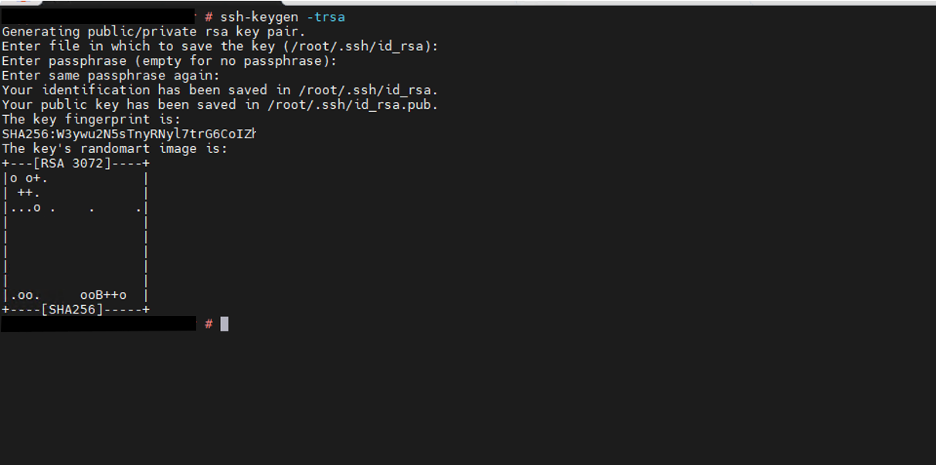
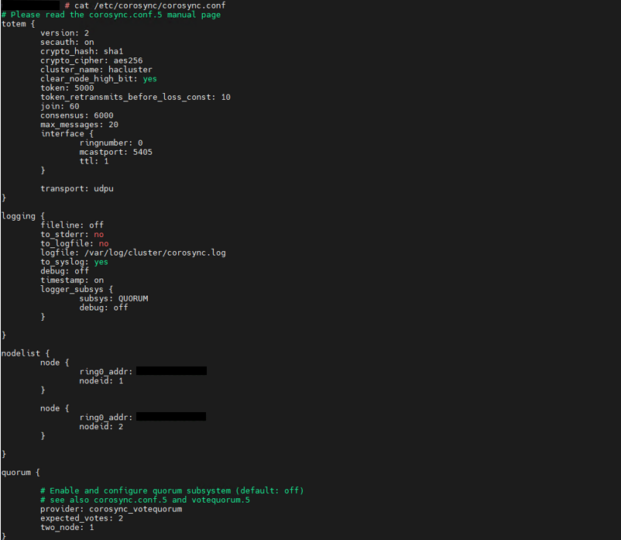
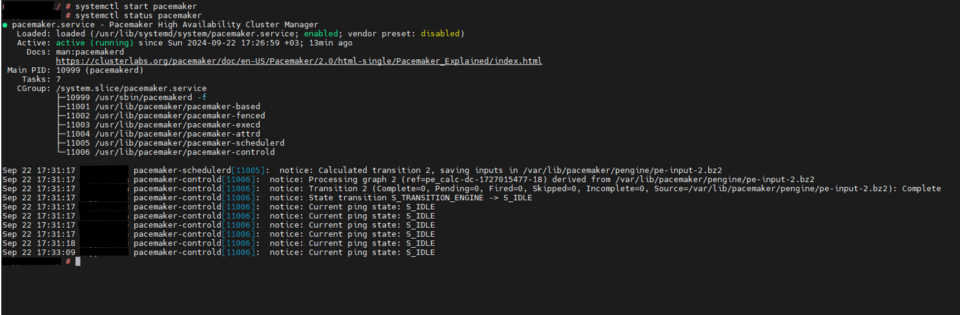
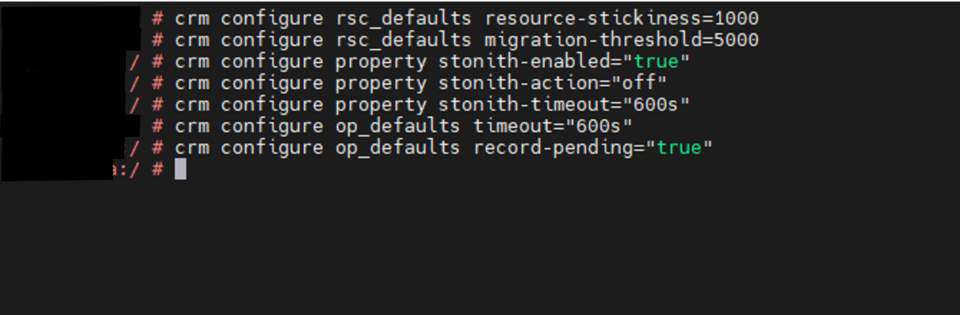
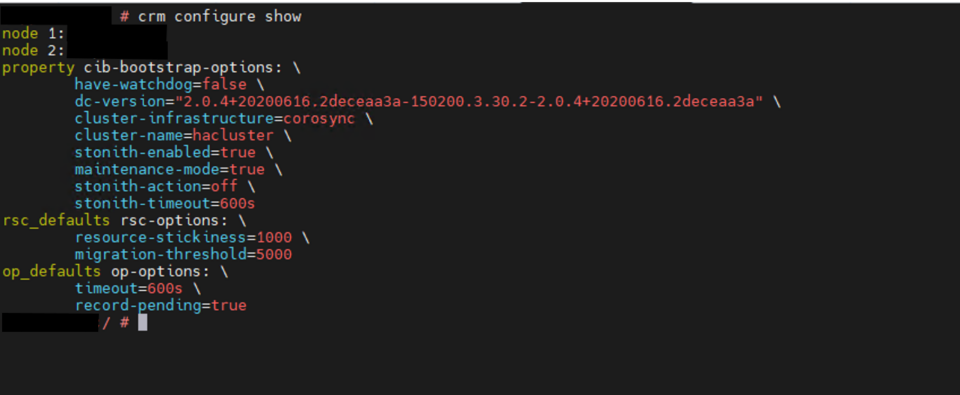
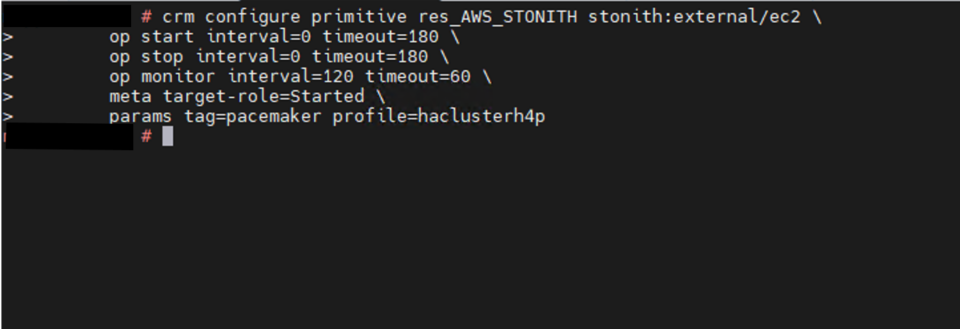
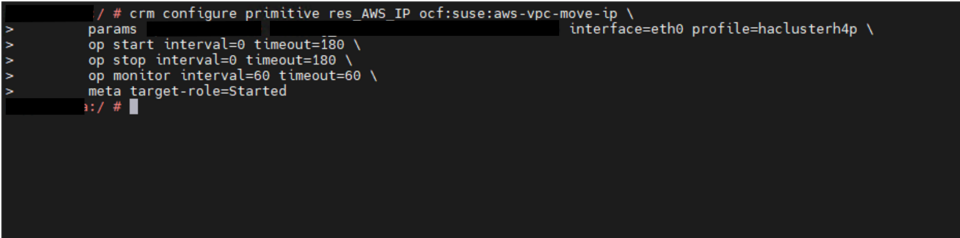
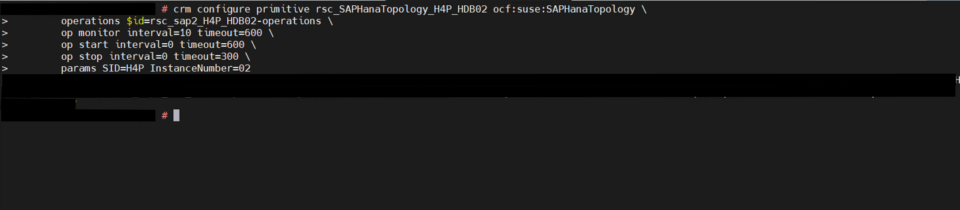
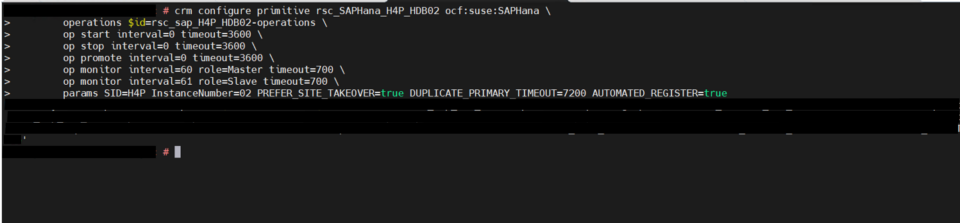
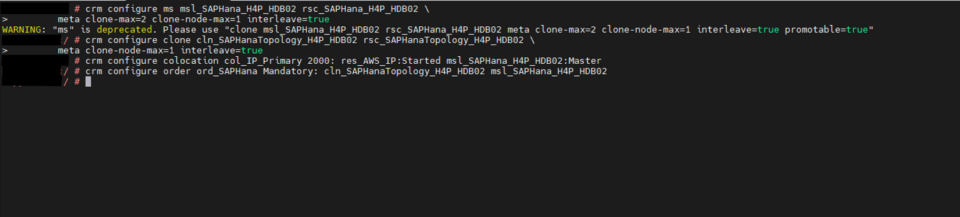
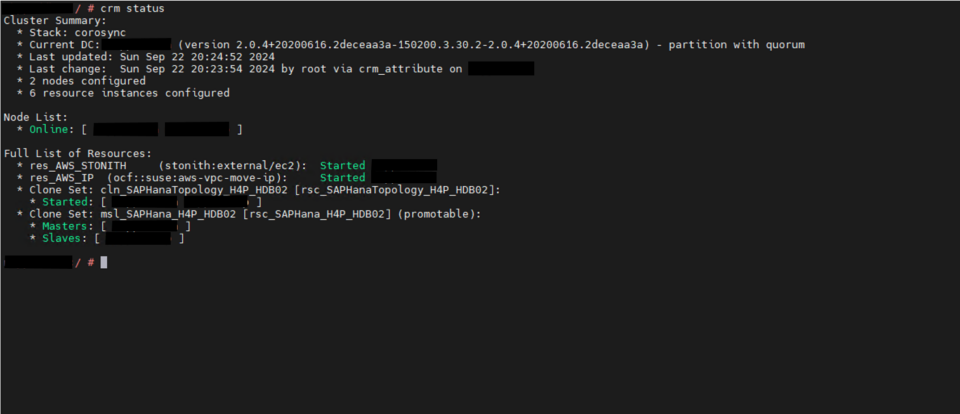
يقوم نهج SUSE بأتمتة عملية takeover في بيئات SAP HANA System Replication. ورغم أن تكرار البيانات إلى مثيل SAP HANA ثانوي يضمن توافر البيانات، فإنه لا يضمن استمرارية النظام وحده. ولتعزيز التوافر العالي، نحتاج إلى حل cluster يدير عملية تجاوز الفشل ويضمن استمرار وصول العملاء عبر نقل عنوان الخدمة.
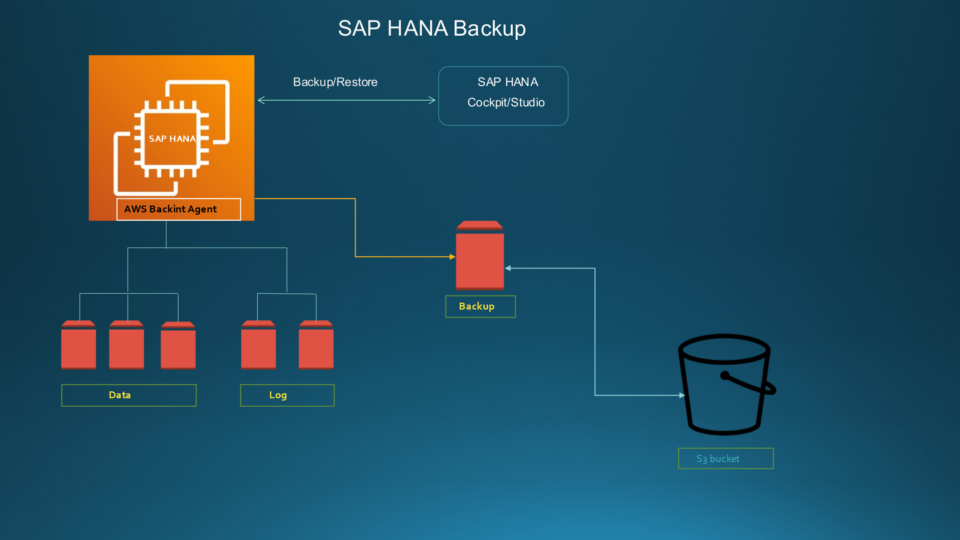
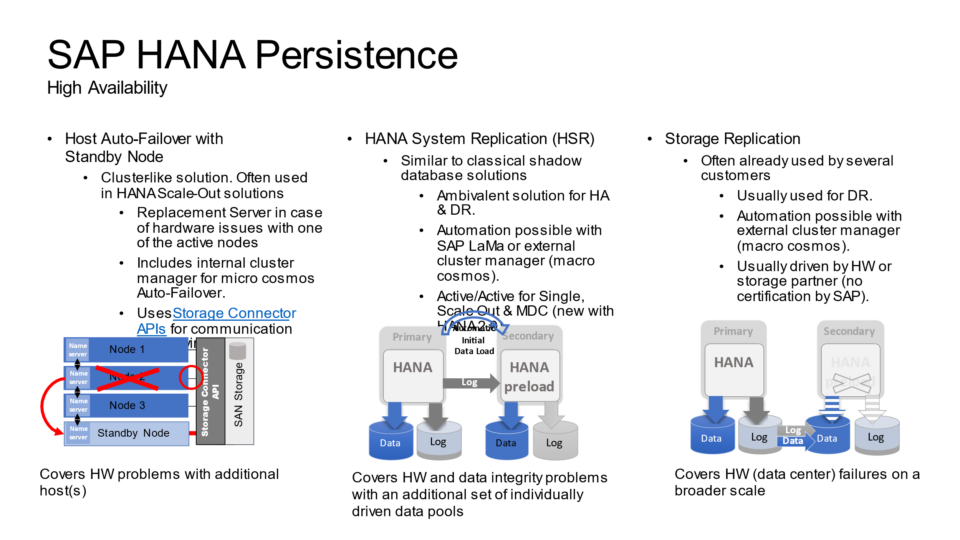
تم تصميم نشر SAP HANA على AWS لتوفير التوافر العالي وتحمل الأعطال على مستوى البنية التحتية. ومع ذلك، لا تزال الأعطال على مستوى قاعدة بيانات SAP HANA تحتاج إلى إدارة. عند حدوث مشكلة في العتاد أو البرامج، يمكن بدء failover يدوي باستخدام SAP HANA Cockpit أو SAP HANA Studio أو أداة hdbnsutil. وقد تؤدي هذه الإجراءات اليدوية إلى انقطاعات مؤقتة في الأعمال.
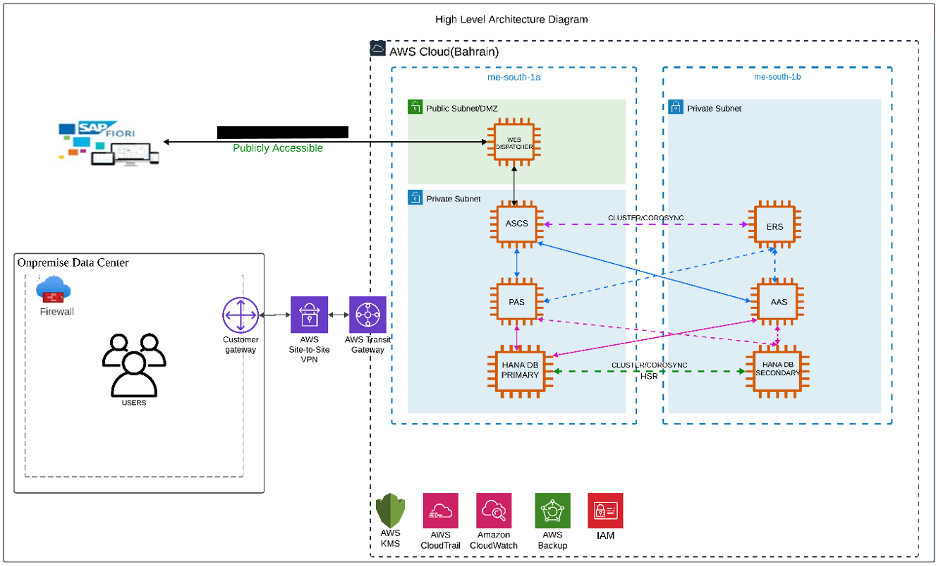
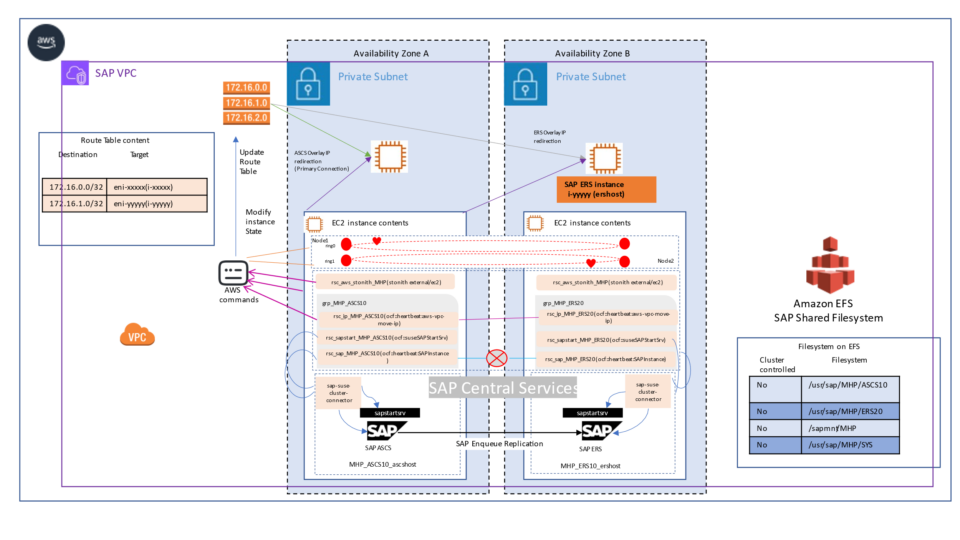
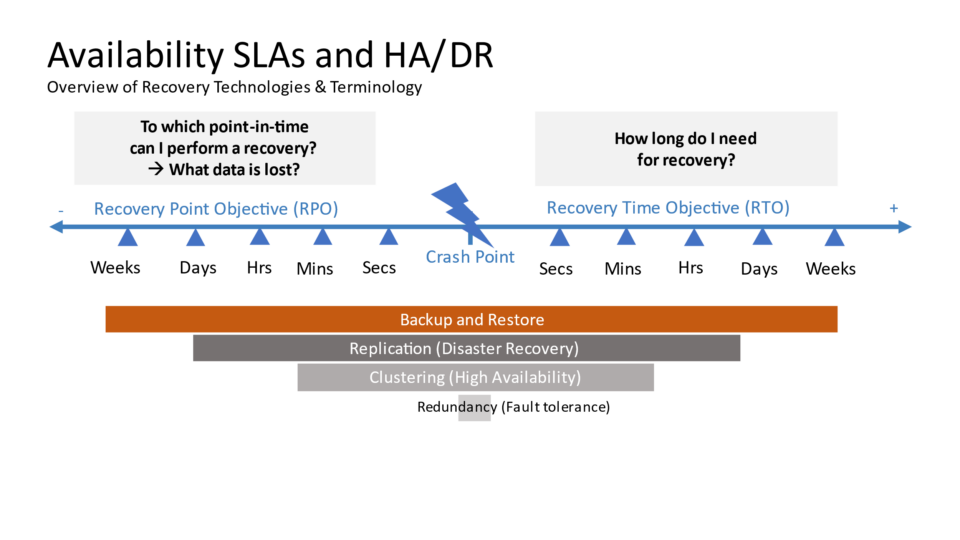
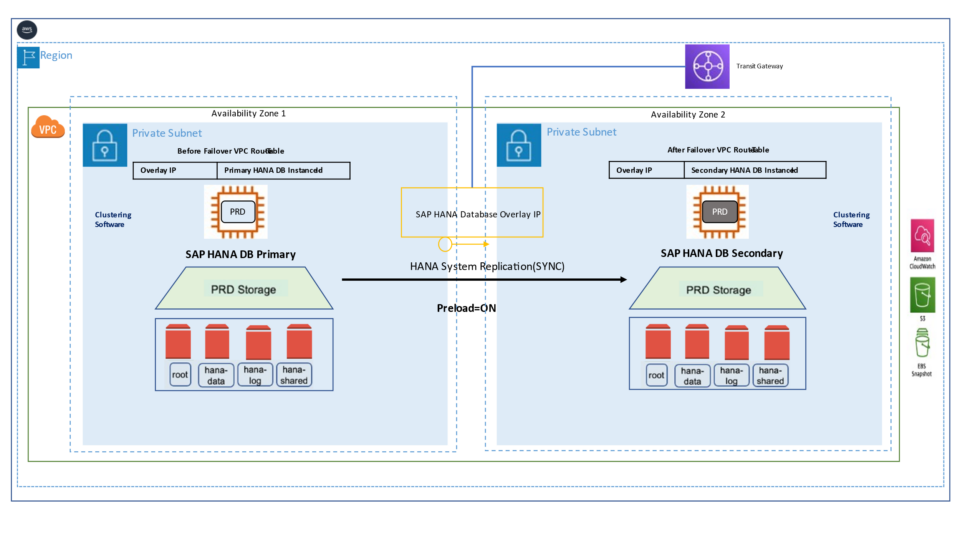
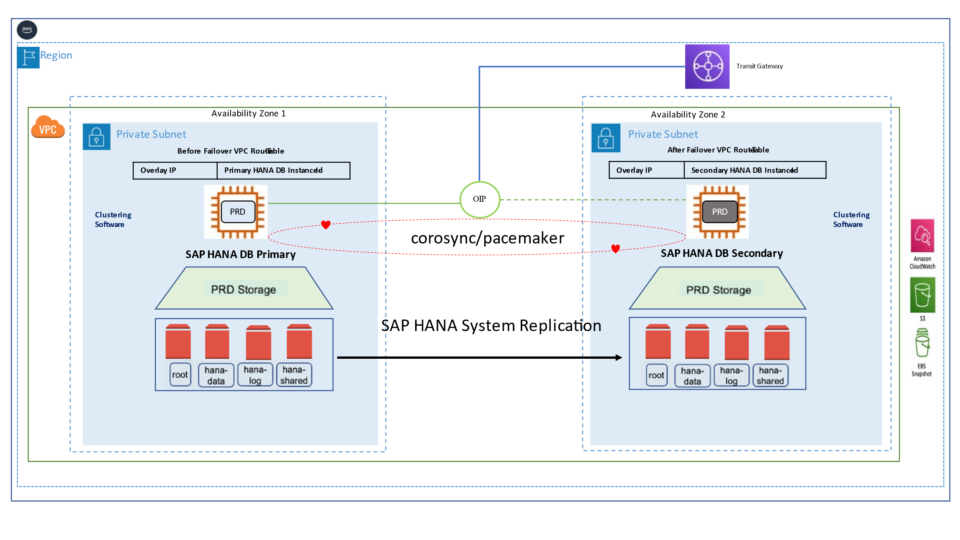
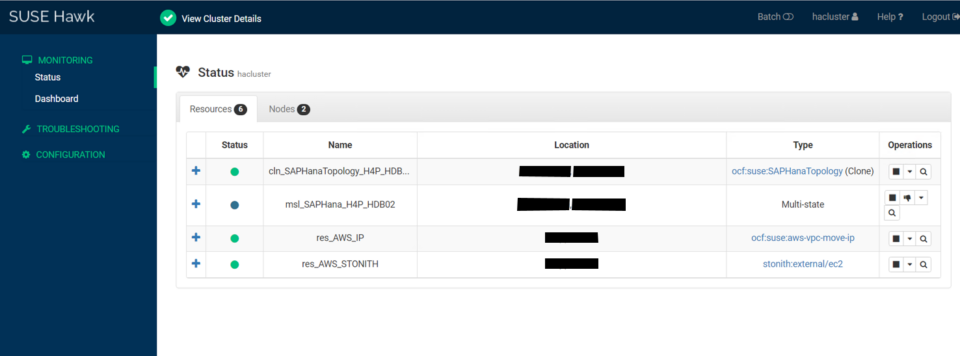
يتيح إعداد التوافر العالي لـ SAP HANA باستخدام System Replication تجاوز فشل آلياً بين المثيلين الأساسي والثانوي. يتم تكوين المثيلين داخل Pacemaker cluster يعمل على مستوى نظام التشغيل ويتكامل مع SAP HANA عبر hooks متخصصة. يراقب هذا الحل النظام باستمرار ويبدأ failover تلقائياً عند الحاجة، وغالباً ما تتحقق الاستعادة خلال دقائق أو أسرع.
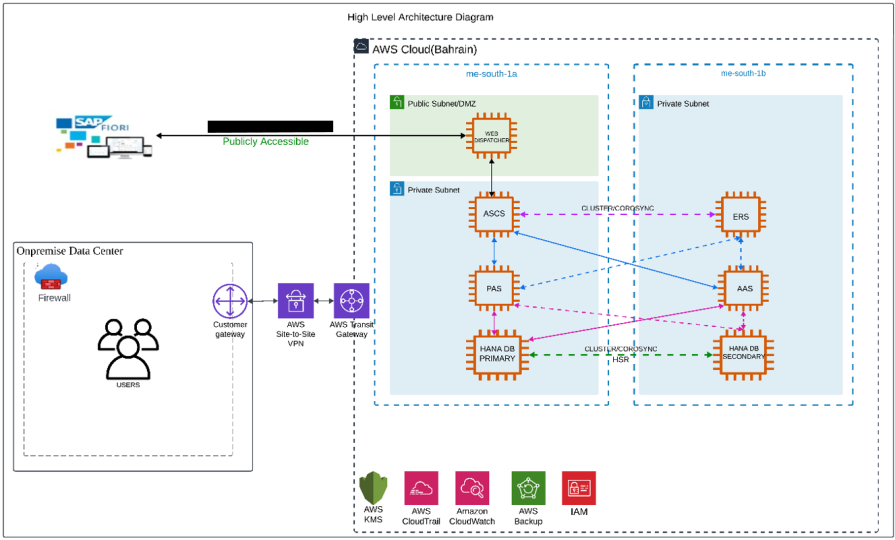
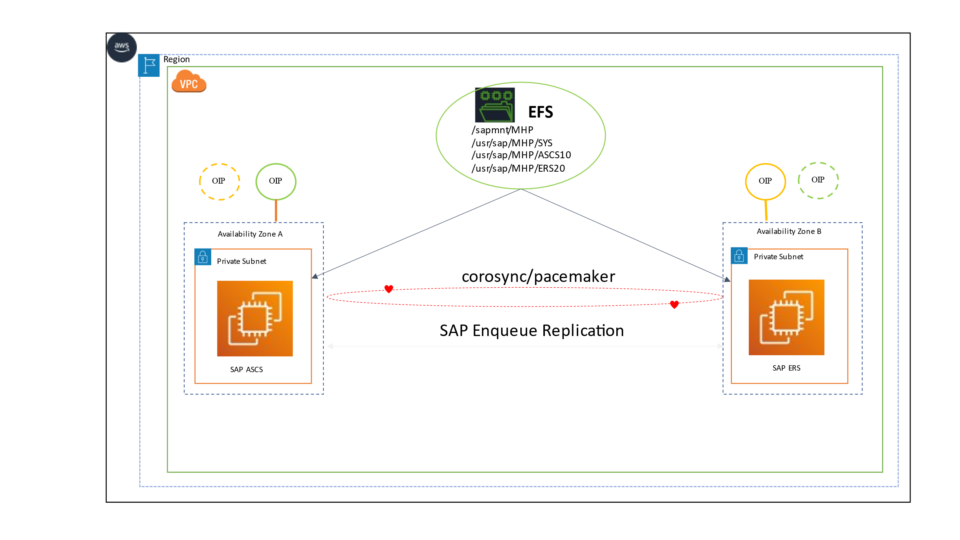
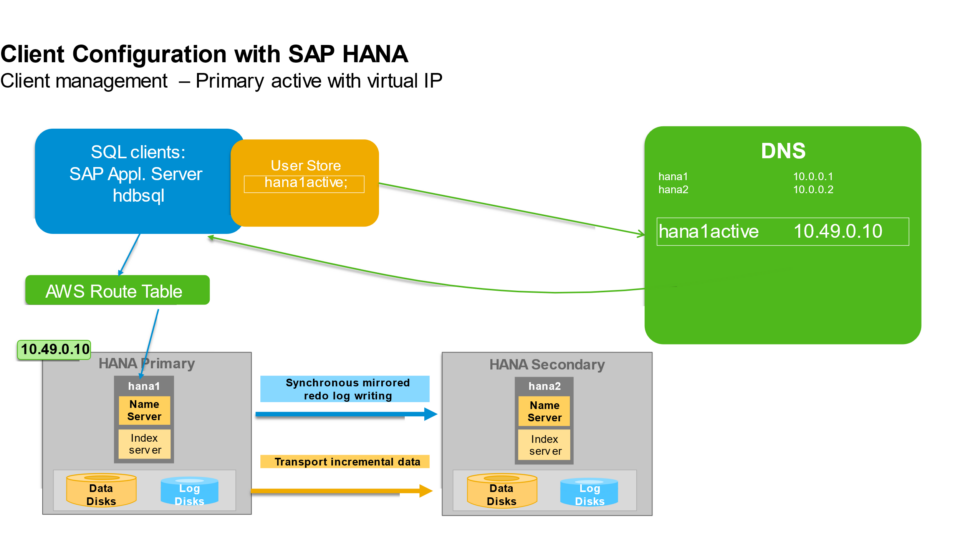
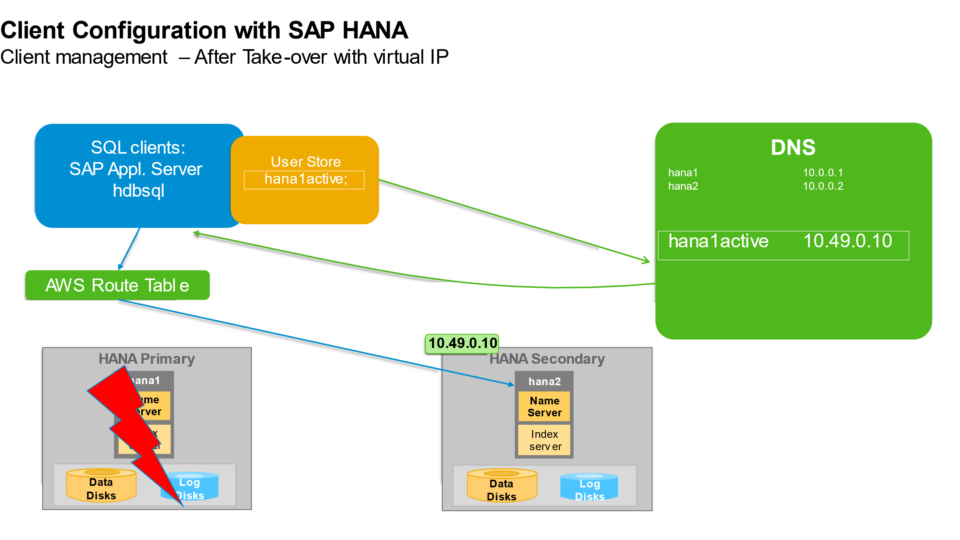
يستخدم Pacemaker cluster عنوان IP افتراضياً لتوجيه الحركة إلى مثيل SAP HANA master النشط. أثناء failover، يتم نقل هذا العنوان إلى المثيل الاحتياطي الذي تتم ترقيته ليصبح الأساسي الجديد. وعلى AWS، يستخدم عنوان Overlay IP ليشير دائماً إلى عقدة SAP HANA النشطة، سواء كانت العقدة الأساسية الأصلية أو النظام الثانوي.
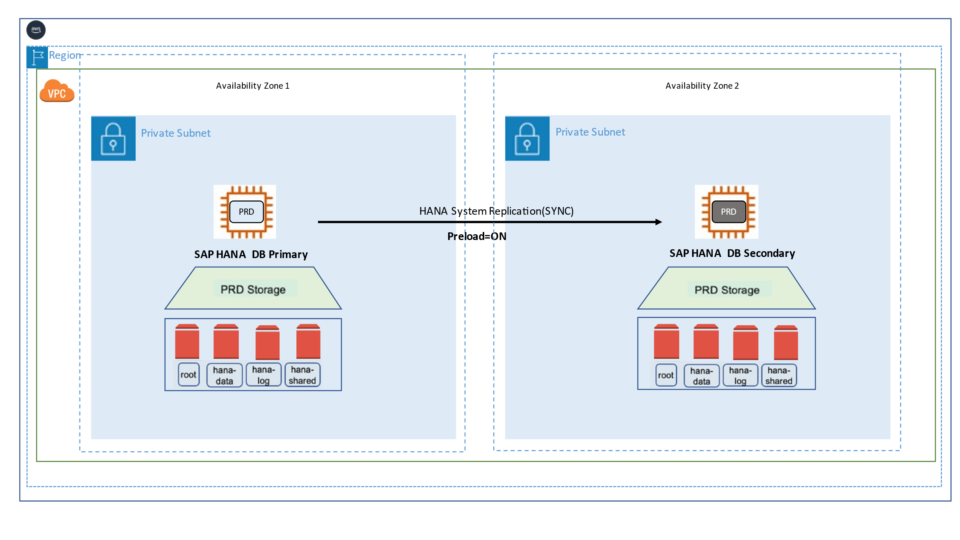
تنظم AWS بنيتها في Regions وAvailability Zones. ويساعد النشر عبر أكثر من Availability Zone داخل Region واحدة على تحسين تحمل الأعطال وتقليل تأثير الأعطال المحلية. في مشروعنا، قمنا بتكوين نظام ثانوي Active/Passive وفق سيناريو Performance Optimized. يقيّد System Replication الوصول للقراءة وتنفيذ SQL على النظام الثانوي حتى يحدث takeover وينتقل الدور النشط من الأساسي إلى الثانوي. يعمل الثانوي كـ hot standby باستخدام وضع log replay. وإذا فشل نظام SAP HANA الأساسي، يبدأ cluster عملية takeover، مستفيداً من البيانات المحملة مسبقاً لتسريع الاستعادة مقارنة بإعادة تشغيل محلية كاملة.